Exemples
Regrouper deux ensembles denses et une observation de bruit.
X = [0 0; 0 0.1; 5 5; 5 5.1; 10 10];
[idx, corepts] = dbscan(X, 0.2, 2)
Renvoyer seulement les etiquettes de groupes.
X = [0 0; 0 0.1; 5 5; 5 5.1];
idx = dbscan(X, 0.2, 2)
Utiliser une valeur minpts plus grande pour marquer toutes les observations comme bruit.
X = [0; 0.1];
[idx, corepts] = dbscan(X, 1, 3)
Les points exactement a epsilon sont inclus dans le voisinage.
X = [0; 1; 2];
idx = dbscan(X, 1, 2)
Regrouper des lignes dupliquees avec un tres petit rayon.
X = [1 1; 1 1; 1 1; 5 5];
[idx, corepts] = dbscan(X, 1e-12, 3)
Utiliser la distance euclidienne au carre.
X = [0 0; 0.1 0.05; 5 5; 5.05 5.05];
idx = dbscan(X, 1, 2, 'Distance', 'squaredeuclidean')
Utiliser la distance city block.
X = [0 0; 0.1 0.05; 5 5; 5.05 5.05];
idx = dbscan(X, 0.2, 2, 'Distance', 'cityblock')
Utiliser la distance de Chebychev.
X = [0 0; 0.1 0.05; 5 5; 5.05 5.05];
idx = dbscan(X, 0.1, 2, 'Distance', 'chebychev')
Utiliser la distance de Minkowski avec l'exposant 1.
X = [0 0; 0.1 0.05; 5 5; 5.05 5.05];
idx = dbscan(X, 0.2, 2, 'Distance', 'minkowski', 'P', 1)
Utiliser la distance euclidienne standardisee avec une echelle explicite.
X = [0 0; 0.1 0.05; 5 5; 5.05 5.05];
idx = dbscan(X, 0.2, 2, 'Distance', 'seuclidean', 'Scale', [1 1])
Utiliser la distance de Mahalanobis avec une matrice de covariance explicite.
X = [0 0; 0.1 0.05; 5 5; 5.05 5.05];
idx = dbscan(X, 0.2, 2, 'Distance', 'mahalanobis', 'Cov', eye(2))
Utiliser la distance cosinus pour regrouper les observations de meme direction.
X = [1 0; 2 0; 0 1; 0 2];
idx = dbscan(X, 0.01, 2, 'Distance', 'cosine')
Utiliser la distance de correlation.
X = [1 2; 2 3; 10 9; 11 10];
idx = dbscan(X, 0.01, 2, 'Distance', 'correlation')
Utiliser la distance de Spearman.
X = [1 2; 2 3; 10 9; 11 10];
idx = dbscan(X, 0.01, 2, 'Distance', 'spearman')
Utiliser la distance de Hamming sur des lignes binaires.
X = [1 0 0; 1 0 0; 0 1 0; 0 1 0];
idx = dbscan(X, 0.01, 2, 'Distance', 'hamming')
Utiliser la distance de Jaccard sur des motifs creux.
X = [1 0 0; 1 0 0; 0 1 0; 0 1 0];
idx = dbscan(X, 0.01, 2, 'Distance', 'jaccard')
Utiliser un handle de fonction de distance personnalise.
X = [0 0; 0 0.1; 5 5; 5 5.1; 10 10];
f = @(row, A) sqrt((A(:, 1) - row(1)).^2 + (A(:, 2) - row(2)).^2);
idx = dbscan(X, 0.2, 2, 'Distance', f)
Utiliser une matrice carree de distances pre-calculees.
X = [0; 0.1; 5; 5.1; 10];
D = abs(X - X');
idx = dbscan(D, 0.2, 2, 'Distance', 'precomputed')
Utiliser un vecteur compact de distances pre-calculees.
Dv = [0.1 5 5.1 10 4.9 5 9.9 0.1 5 4.9];
idx = dbscan(Dv, 0.2, 2, 'Distance', 'precomputed')
Utiliser une matrice logique de voisinage pre-calculee.
B = [true true false; true true true; false true true];
idx = dbscan(B, [], 2, 'Distance', 'precomputed')
Utiliser un vecteur logique compact de voisinages pre-calcules.
Bv = [true false false true false true];
idx = dbscan(Bv, [], 2, 'Distance', 'precomputed')
Tracer des groupes allonges avec des points aberrants.
f = figure();
rng(11);
n = 70;
u = 2 * rand(n, 1) - 1;
v = 2 * rand(n, 1) - 1;
X1 = [1.2 * u - 1.4, 0.35 * u + 0.12 * rand(n, 1)];
X2 = [0.25 * v + 2.0, 1.2 * v + 0.18 * rand(n, 1) + 1.2];
X3 = [4.8 * rand(18, 1) - 2.2, 3.8 * rand(18, 1) - 1.3];
X = [X1; X2; X3];
idx = dbscan(X, 0.32, 6);
c = idx;
c(c < 0) = 0;
scatter(X(:, 1), X(:, 2), 36, c, 'filled');
axis equal;
title('Groupes allonges avec points aberrants');
xlabel('x1');
ylabel('x2');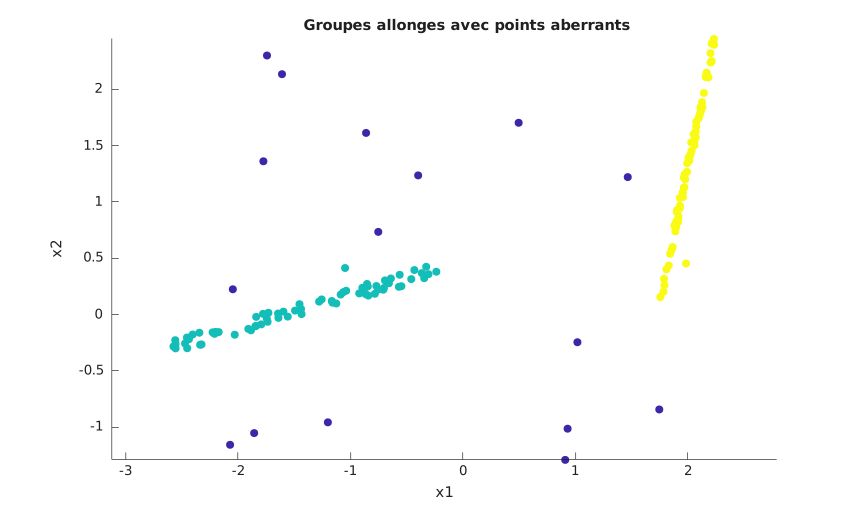
Tracer des groupes de formes et tailles differentes.
f = figure();
rng(12);
n1 = 90;
n2 = 55;
n3 = 70;
theta = 2 * pi * rand(n1, 1);
r = 0.35 * sqrt(rand(n1, 1));
X1 = [r .* cos(theta) - 1.6, r .* sin(theta) + 1.0];
X2 = [0.9 * rand(n2, 1) + 1.2, 0.25 * rand(n2, 1) - 1.1];
X3 = [0.35 * (rand(n3, 1) - 0.5) + 0.5, 1.2 * (rand(n3, 1) - 0.5) + 1.6];
X = [X1; X2; X3];
idx = dbscan(X, 0.28, 5);
c = idx;
c(c < 0) = 0;
scatter(X(:, 1), X(:, 2), 36, c, 'filled');
axis equal;
title('Groupes de formes et tailles differentes');
xlabel('x1');
ylabel('x2');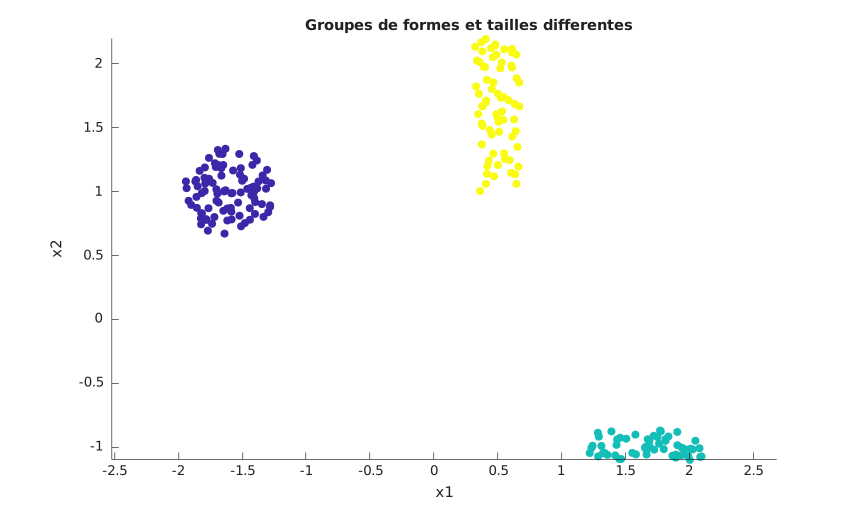
Tracer deux bandes sinusoidales.
f = figure();
rng(13);
n = 140;
t = linspace(-2.5, 2.5, n)';
X1 = [t, sin(1.3 * t)] + 0.08 * (rand(n, 2) - 0.5);
X2 = [t, sin(1.3 * t) - 1.1] + 0.08 * (rand(n, 2) - 0.5);
X = [X1; X2];
idx = dbscan(X, 0.18, 5);
c = idx;
c(c < 0) = 0;
scatter(X(:, 1), X(:, 2), 36, c, 'filled');
axis equal;
title('Bandes sinusoidales');
xlabel('x1');
ylabel('x2');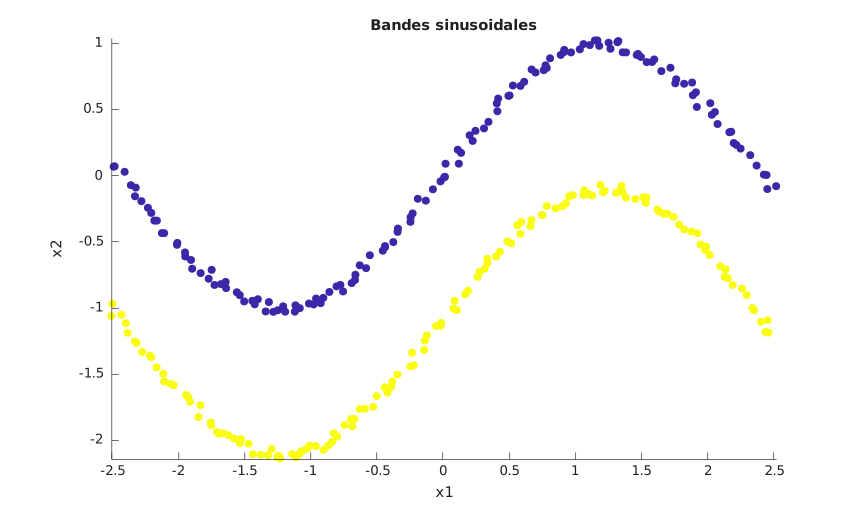
Tracer des groupes en arcs separes.
f = figure();
rng(14);
t1 = linspace(0.2 * pi, 1.55 * pi, 150)';
t2 = linspace(1.85 * pi, 3.15 * pi, 130)';
r1 = 1 + 0.05 * (rand(150, 1) - 0.5);
r2 = 1 + 0.05 * (rand(130, 1) - 0.5);
X1 = [r1 .* cos(t1), r1 .* sin(t1)] + [-1.2, 0.2];
X2 = [1.1 * r2 .* cos(t2), 0.65 * r2 .* sin(t2)] + [1.4, -0.3];
X3 = [4 * rand(20, 1) - 2, 2.6 * rand(20, 1) - 1.3];
X = [X1; X2; X3];
idx = dbscan(X, 0.18, 5);
c = idx;
c(c < 0) = 0;
scatter(X(:, 1), X(:, 2), 36, c, 'filled');
axis equal;
title('Groupes en arcs separes');
xlabel('x1');
ylabel('x2');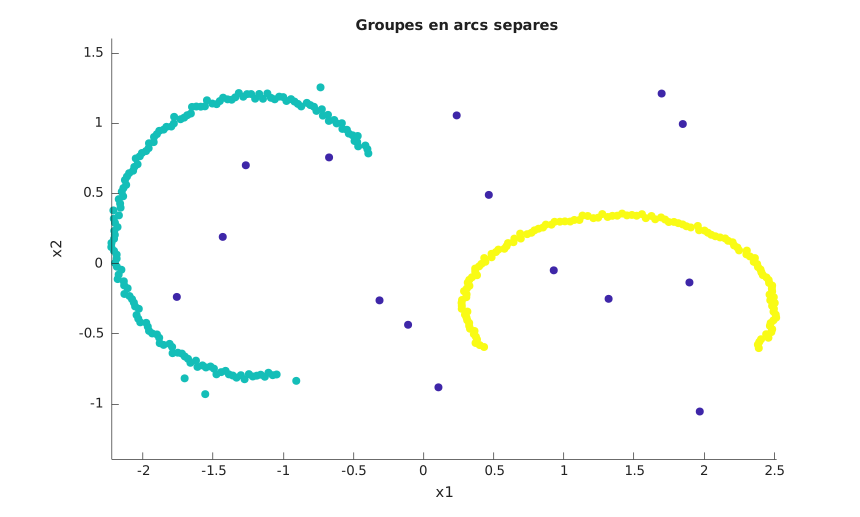
Tracer un ruban ondule et un ilot dense.
f = figure();
rng(15);
n = 220;
t = linspace(0, 4 * pi, n)';
X1 = [t / (2 * pi) - 1, 0.5 * sin(t)] + 0.07 * (rand(n, 2) - 0.5);
X2 = 0.18 * (rand(80, 2) - 0.5) + [0.8, 1.0];
X3 = [2.8 * rand(20, 1) - 1.4, 2.6 * rand(20, 1) - 1.1];
X = [X1; X2; X3];
idx = dbscan(X, 0.14, 5);
c = idx;
c(c < 0) = 0;
scatter(X(:, 1), X(:, 2), 36, c, 'filled');
axis equal;
title('Ruban ondule et ilot dense');
xlabel('x1');
ylabel('x2');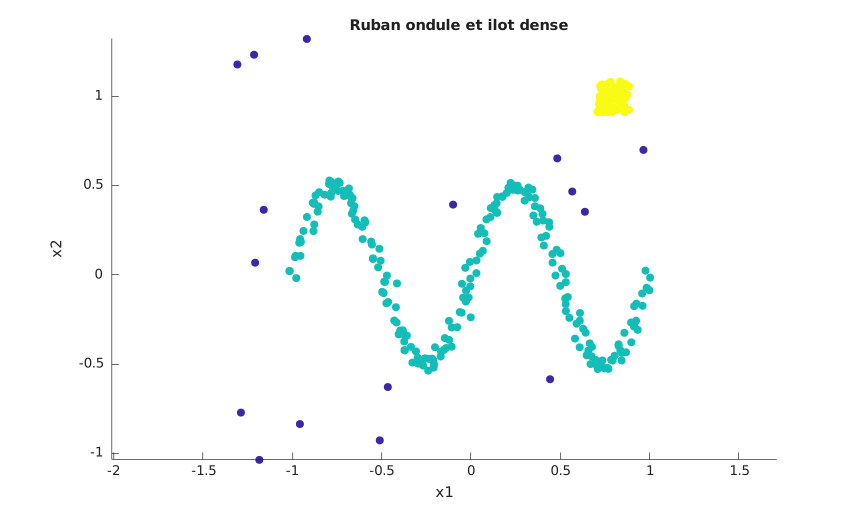
Tracer des groupes en angles droits avec la distance city block.
f = figure();
rng(16);
n = 70;
t = linspace(0, 1, n)';
X1 = [[t, zeros(n, 1)]; [ones(n, 1), t]] + 0.04 * (rand(2 * n, 2) - 0.5) - [1.7, 0.4];
X2 = [[-t, zeros(n, 1)]; [-ones(n, 1), t]] + 0.04 * (rand(2 * n, 2) - 0.5) + [1.7, -0.4];
X = [X1; X2];
idx = dbscan(X, 0.16, 4, 'Distance', 'cityblock');
c = idx;
c(c < 0) = 0;
scatter(X(:, 1), X(:, 2), 36, c, 'filled');
axis equal;
title('Groupes en angles droits avec la distance city block');
xlabel('x1');
ylabel('x2');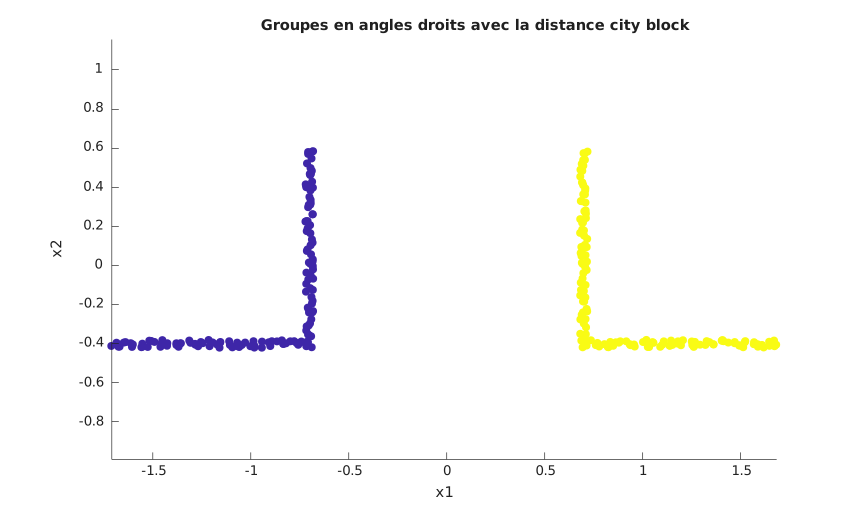
Regrouper deux anneaux avec la distance par defaut.
N = 90;
theta = linspace(0, 2 * pi, N)';
X = [[0.5 * cos(theta), 0.5 * sin(theta)]; [5 * cos(theta), 5 * sin(theta)]];
idx = dbscan(X, 1, 5)
Traiter une matrice de donnees vide.
idx = dbscan(zeros(0, 2), 1, 2)